
クラスメソッド株式会社
システム開発・実装
AWS・Google Cloudなどのクラウドインフラや生成AIの技術支援を行う企業。クラウドの設計・構築、Webアプリケーション開発、生成AIサービスの選定からインフラ構築・アプリ開発までを支援している。
この取り組みに関心があれば、
クラスメソッド株式会社の公式情報をご覧ください
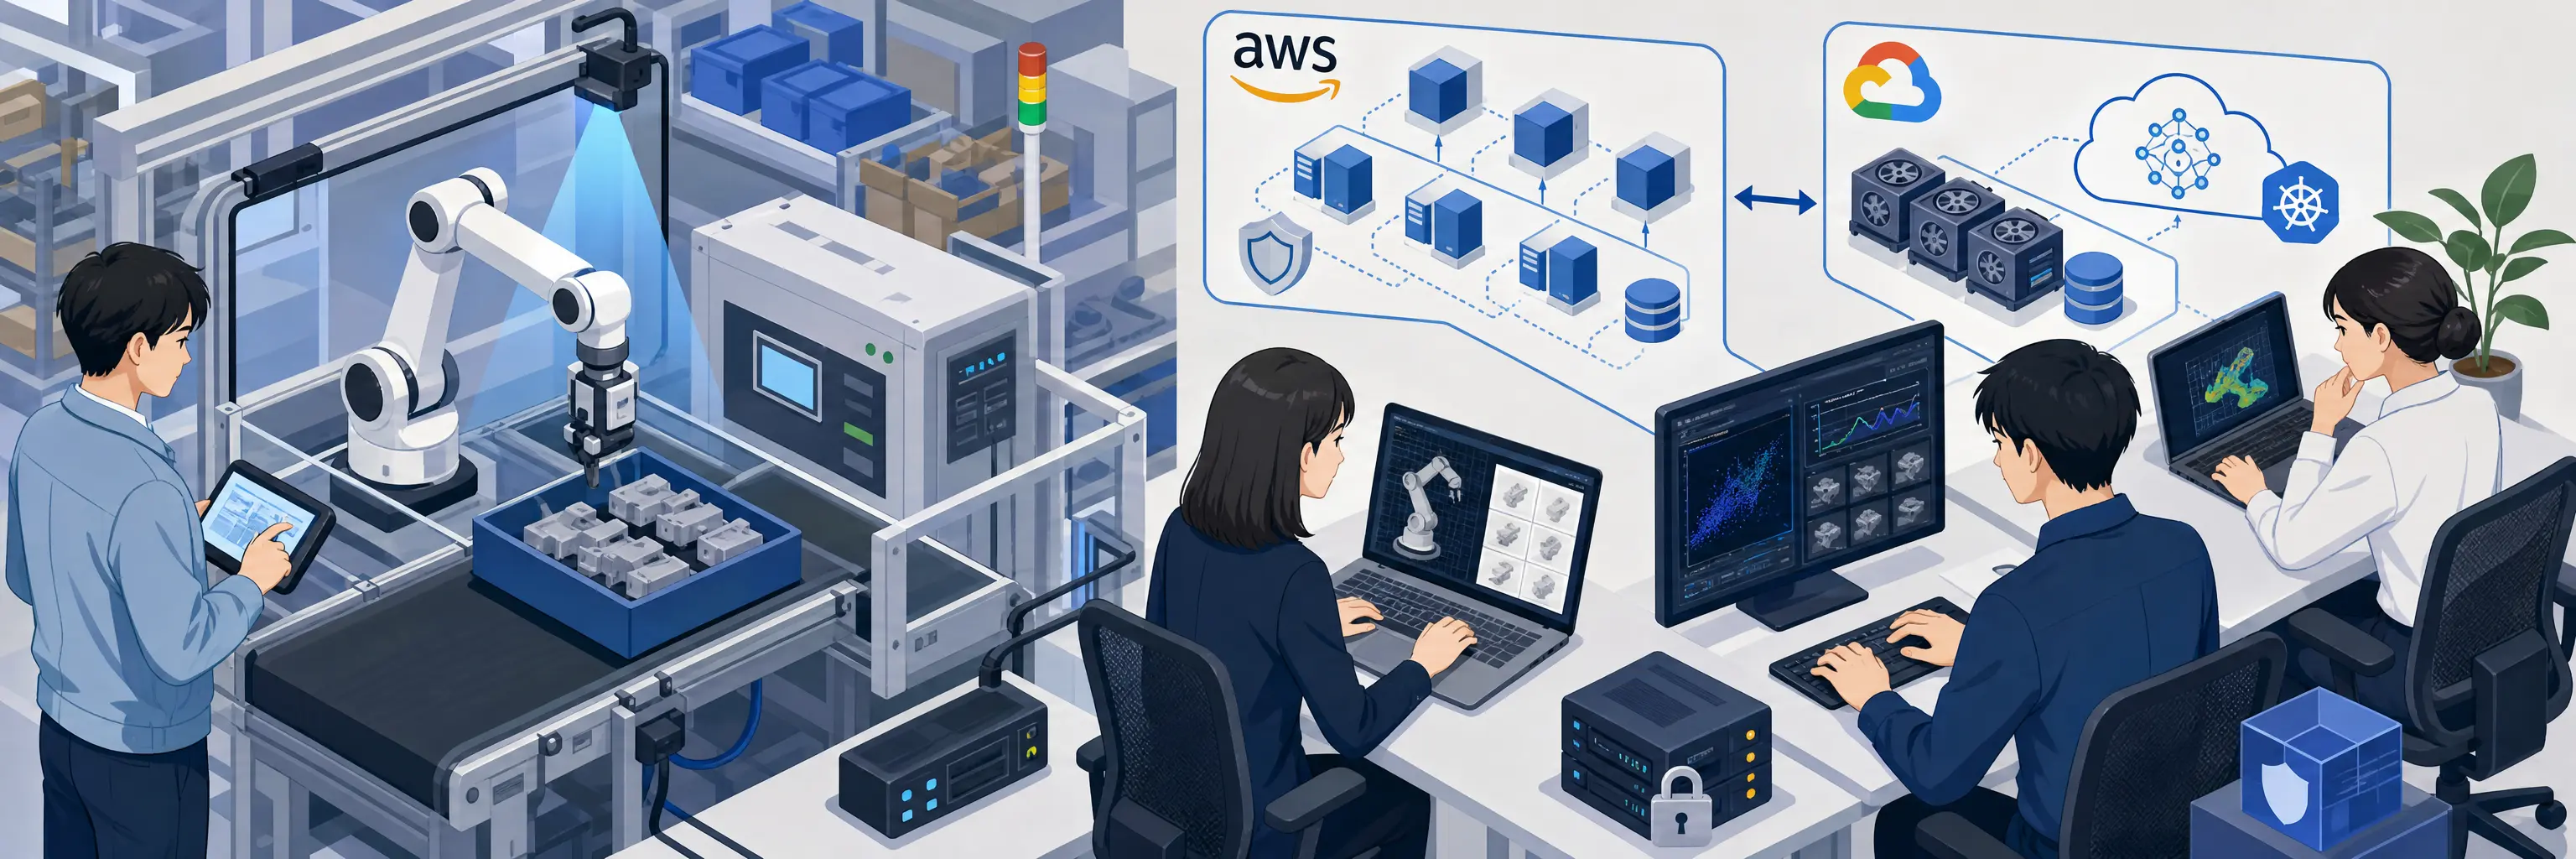 ※イメージ画像です
01 — Overview
京セラのロボティクス事業部は、AIと3Dビジョンで協働ロボットを知能化する「京セラロボティックサービス」を新規事業として開発し、2023年11月にリリースしました。生産現場でロボット制御とAIモデルの推論を担う「AIコントローラー」と、遠隔からの管理・指示や現場データを使ったモデル学習を担う「クラウドプラットフォーム」の二段構えで、サブスクリプション型で提供する構成です。クラウド側は役割で分けられており、データ管理やロボットへの指示はマネージドサービスが豊富なAWS、機械学習はGPUを効率よく使えるGoogle Cloudが担います。開発パートナーとしてクラスメソッドが加わり、AWSのマルチアカウント設計とセキュリティ・ガバナンス対応、サービス管理画面の構築、Google Cloud上の機械学習基盤、機械学習用の合成画像生成ツールのクラウド移行を技術面で支援しました。プロジェクトは2020年10月に始まり、3年に及んでいます。
出典:京セラ様事例|「京セラロボティックサービス」におけるAWSマルチアカウントプラットフォームやGoogle Cloud機械学習基盤の構築に向けた3年間の開発ストーリー| クラスメソッド株式会社 | AWS・生成AI・クラウドの技術支援(発行元:クラスメソッド株式会社)
02 — Problem
出発点にあったのは、生産年齢人口の減少にともなう生産現場の人手不足です。人と同じスペースで作業できる協働ロボットをAIで知能化し、段取り替えが頻繁に発生する多品種少量生産の工程でも使えるようにする、というのが事業の狙いでした。ただし現場でAIモデルを安定して動かすには、照明の変動といった環境の揺らぎに追従し続ける必要があり、そのためにロボットから送られてくる現場データには顧客の機密が含まれます。
編集部の見立てでは、この事業の難所はロボットを賢くする技術そのものではなく、顧客の秘密を預かりながらモデルを学習させ続ける「器」をどう設計するかにありました。学習を回すほど複数の顧客の機密データがクラウド側に集まり、一度の事故で及ぶ範囲も広がっていきます。しかも開発チームにとってGoogle Cloudでの構築はほぼ初めてで、AWS側でも複数アカウントを統合管理する知見が求められる状態でした。技術的な課題と、サービスとして売るための信頼設計とが地続きになっていた点が、この事例の起点だと考えられます。
03 — Key points
クラウドを一つに統一せず、機能ごとに得意な方を割り当てた設計が、この開発の土台になっています。データ管理やロボットへの指示は、マネージドサービスが豊富で開発を速く進められるAWS、機械学習はGPUを有効に使えるGoogle Cloudという分担です。後者では、GPUを常時抱え込むと高コストになるという事情から、必要な量だけ計算資源を増減させるオートスケールを、コンテナをまとめて動かすGoogle Kubernetes Engine(GKE)で組んでいます。基盤を一つに寄せたほうが管理は楽になるのが通例ですが、GPUをどれだけ無駄なく回せるかがサブスクリプション型サービスの原価に直結する以上、運用の手間を引き受けてでも分ける判断には筋が通っています。
顧客ごとにAWSアカウントを分け、データを論理的に切り離す方式も、信頼を先に設計した選択でした。まとめて管理する仕組みには既製のAWS Control Towerという選択肢もありましたが、技術選定当時の自分たちには過剰で柔軟性に欠けると判断し、AWS Organizationsで組み立てる道を選んでいます。ベストプラクティスを参照しつつ管理用アカウントの構成を自社のドメインに合わせて設計した点、そして顧客が増えるほどクラスタの費用が膨らむと分かった段階で、2023年にクラスタを顧客アカウントの外へ出し、Assume Roleで各アカウントのサービスやデータへ接続するマルチテナント構成へ切り替えた点。ここには、初期設計を守り抜くより運用の現実に合わせて作り替えるという判断が表れています。
学習データを作る側まで手を入れたことも見落とせません。3D CADデータからさまざまな条件で画像を自動生成する合成画像生成ツールは、もともとオンプレミスで動く一体型のアプリケーションでしたが、役割ごとに分割してコンテナ化し、GKE上で動くよう作り直されました。ほぼ作り直しに近く開発に9カ月を要した回り道ですが、モデルの頑健さはデータオーグメンテーション(学習用データの水増し・拡張)の量と質に左右されるため、推論側ではなく供給側を強くする発想は理にかなっています。
04 — Results
プロジェクトは2020年10月に始まり、2023年11月のサービスリリースに至りました。2024年1月時点で京セラ社内での利用が始まっており、外部企業からもいくつかの引き合いが寄せられています。途中で実施した管理画面のマルチテナント化は、既存アプリケーションに大きな影響を与えることなく2カ月で切り替えが完了しました。合成画像生成ツールのクラウド化では、多くのAIエンジニアが同時並行で利用できるようになり、データ生成時間も短縮されています。WebアプリでのFirebase活用による開発工数の大幅短縮と運用負荷の軽減も、あわせて生まれた効果です。
05 — For your company
応用しやすいのは、顧客の機密データを預かりながらAIモデルを育て続けるタイプのサービスです。テナントの分け方は後から変えると影響範囲が大きいため、顧客単位で環境ごと分けるのか、共通基盤の中を権限で仕切るのかを、契約条件や監査要件と一緒に最初に決めておく価値があります。GPUの使い方も同じで、学習の頻度に波があるなら、資源を抱え込まずに必要な分だけ増減させる構成のほうが原価は読みやすくなります。
一方で、この形がそのまま効く場面は限られます。顧客数がまだ少ない段階で顧客ごとに環境を分けると、この事例で実際に構成を組み替えたように固定費のほうが先に立ちますし、3年かけて支援範囲を段階的に広げられる体制や、外部から出てくる提案の妥当性を社内で判断できる技術者がいることも前提になります。まず手をつけるとすれば、いまAIの学習に使っているデータのうち、どこからが顧客の資産で、どこからが自社の資産なのか。その一線を引いてみると、自社に必要な分離の粒度が見えてきます。
06 — Company
システム開発・実装
AWS・Google Cloudなどのクラウドインフラや生成AIの技術支援を行う企業。クラウドの設計・構築、Webアプリケーション開発、生成AIサービスの選定からインフラ構築・アプリ開発までを支援している。
この取り組みに関心があれば、
クラスメソッド株式会社の公式情報をご覧ください
07 — Category
関連度の高い事例を選定しています。少しお待ちください。