株式会社ELYZA
東京大学松尾研究室発のAIスタートアップ。「未踏の領域で、あたりまえを創る」という理念のもと、日本語の大規模言語モデルに焦点を当て、企業との共同研究やクラウドサービスの開発を行う。先端技術の研究開発とコンサルティングによって言語生成AIの導入実装を推進する。
この取り組みに関心があれば、
株式会社ELYZAの公式情報をご覧ください
 ※イメージ画像です
01 — Overview
JWCRが運営する案内コンタクトセンターは、月におよそ7万件の電話問い合わせを受け付け、応対の内容をテキストとして保存してきました。ただし対話ログをそのまま残すだけでは共有に向かず、要約はオペレーターの手作業に委ねられていました。この要約の素案づくりを言語生成AIに担わせるため、ELYZAと共同プロジェクトを組み、通話内容の要約という用途に絞ったAIサービスを構築しています。基盤となる大規模言語モデルにはAzure OpenAIのGPTシリーズを据え、問い合わせの内容に応じてGPT-3.5とGPT-4を切り替える構成を採りました。2023年5月から8月の実証実験で事後処理時間の短縮幅を確かめたうえで、同年9月には実業務への正式導入へと進んでいます。
出典:20230921_00_press_customercenter_ai.pdf(発行元:株式会社JR西日本カスタマーリレーションズ、株式会社ELYZA)
02 — Problem
月7万件という通話量に対し、記録をテキスト化するところまでは仕組みで回っていた一方、そこから先の要約は一人ひとりの手元に残されたままでした。作業の負荷が重いことに加え、担当するオペレーターによって要約の粒度や書きぶりが揃わない状態も続いていました。
編集部の見立てでは、この困りごとの中心にあったのは作業量そのものではなく、要約が応対の付随作業として扱われ続けた構造です。要約とは、長い対話のうちどこが後から必要になるかを判断して切り出す仕事であり、本来は明確な基準を必要とする工程にあたります。それが応対の合間に個人の裁量で処理されていたために、負荷の集中と品質のばらつきが同時に起きていたのではないでしょうか。
03 — Key points
AIサービスで要約することを前提に、電話応対フローの一部を組織的に組み替えた点が、この取り組みの起点になっています。既存の手順にAIを後から差し込むのではなく、AIが扱いやすい形で通話が進むように業務側を動かした、順序の逆転です。要約の出来は言語生成AIの性能だけで決まるものではなく、入力となる対話がどう構成されているかに大きく左右されます。応対の設計まで射程に入れた判断が、出てきた素案をそのまま使える確率を押し上げたと考えられます。
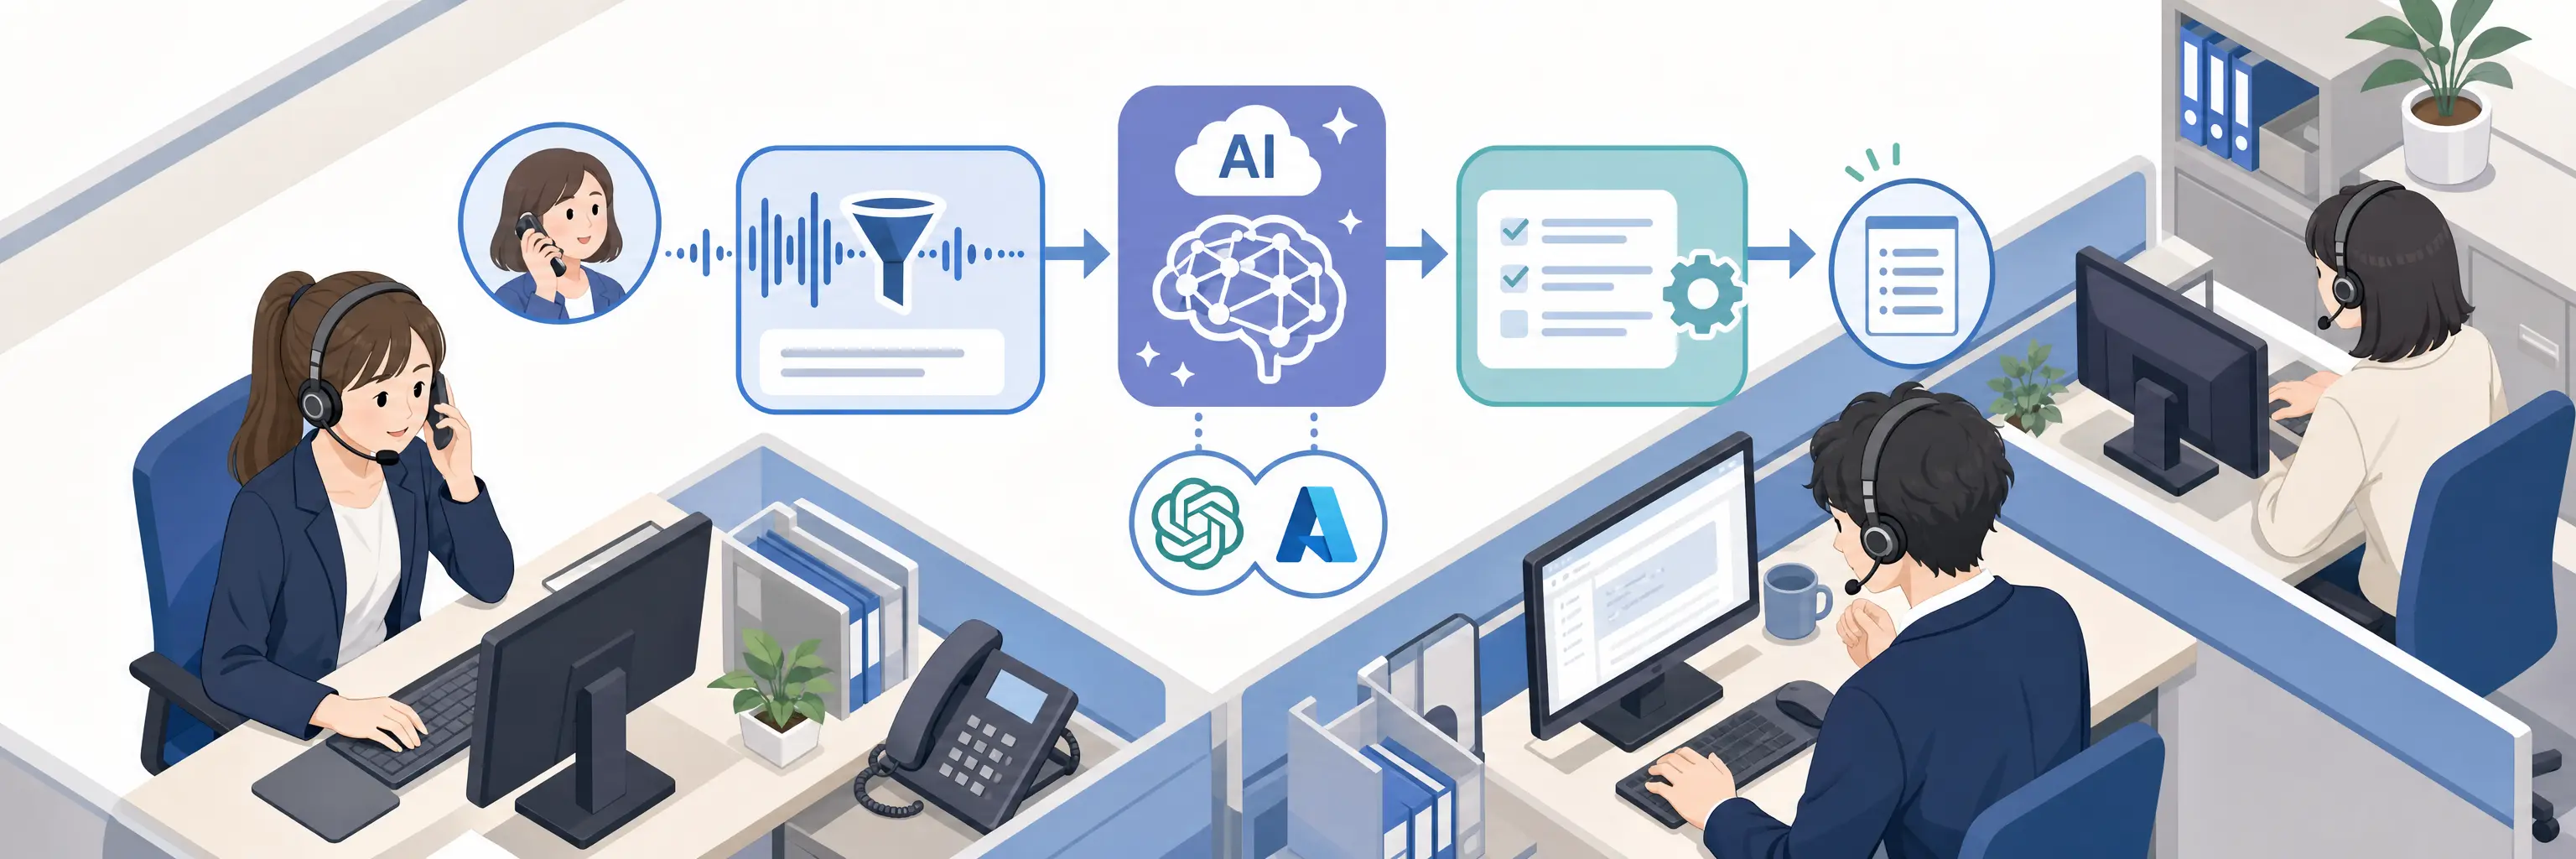
入口と出口の両方に手当てを施した一気通貫の設計も、実運用に耐える品質を支えています。音声データからフィラー(「えー」「あのー」のような意味を持たない言葉)を取り除いてAIが読み取りやすい形に整え、出力側では自社の表現や表記ルールに合わせて直す後処理を挟む構成です。問い合わせの内容に応じてGPT-3.5とGPT-4を使い分けるやり方も、すべてを高性能なモデルに投げるのではなく、必要な場面に精度を配分するという設計思想の表れといえます。
開発側のエンジニアが実際のコンタクトセンターに足を運び、オペレーターと直接対話を重ねた進め方は、この後処理の作り込みに直結したはずです。表記のルールや「この一言は残してほしい」といった要望は仕様書には現れにくく、現場で交わされる言葉の中にしかありません。パートナーであるELYZAが要件定義の外側まで踏み込む体制を取ったからこそ、修正ルールが机上の想定で止まらずに済んだと読み取れます。
04 — Results
2023年5月から8月にかけての実証実験では、後処理に時間がかかっていた「お問い合わせ」「ご意見・ご要望」「介助申込」の3領域について、事後処理時間を18%から54%効率化できることが確認されました。現場のオペレーターからも、簡単な内容はほとんど手直しなしで反映される、とりとめのない内容もうまくまとまる、といった評価が寄せられています。この結果を受けて同年9月から実業務への正式導入が始まり、コンタクトセンターの標準的な業務フロー全体への適用や他領域への展開も視野に入っています。
05 — For your company
応用の見込みが立ちやすいのは、同じ型の対話が日々大量に積み上がり、その記録を後から誰かが読む前提の業務です。営業の商談メモやヘルプデスクの対応履歴のように、書式や必要項目がある程度決まっている領域であれば、前処理と後処理を作り込む手間を件数で回収しやすくなります。
一方、この事例の要点は応対フローそのものを変えたところにあるため、話の展開が案件ごとに大きく異なる相談業務や、業務手順の変更に他部署の合意が必要で現場だけでは動かせない組織では、同じ形をそのまま持ち込むのは難しいでしょう。また、自社の表記ルールが文書として定まっていない状態では、後処理の設計が始められません。
最初の一歩としては、直近の対応記録を数件並べて読み比べ、どの記録にも共通して書かれている項目と、書き手によって有無が分かれる項目を見分けてみるところから。前者はAIの素案で埋められる範囲、後者は人が判断すべき範囲を示す手がかりになります。
06 — Company
東京大学松尾研究室発のAIスタートアップ。「未踏の領域で、あたりまえを創る」という理念のもと、日本語の大規模言語モデルに焦点を当て、企業との共同研究やクラウドサービスの開発を行う。先端技術の研究開発とコンサルティングによって言語生成AIの導入実装を推進する。
この取り組みに関心があれば、
株式会社ELYZAの公式情報をご覧ください
07 — Category
関連度の高い事例を選定しています。少しお待ちください。